릴리패드의 역설: 《토이 스토리 5》로 본 AI 보상 설계의 과학적 검증
Reinforcement Learning, Information Theory, and Bayesian Inference in Toy Story 5
총무 명채현
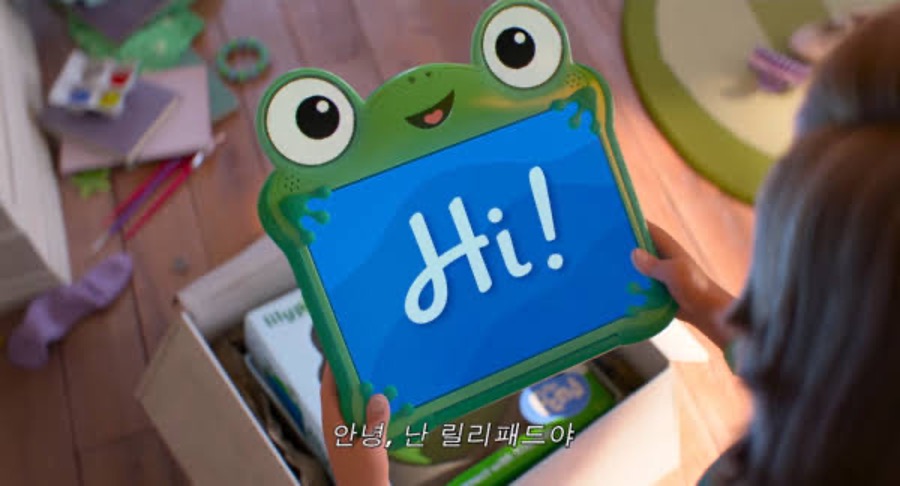
《토이 스토리 5》는 앤드류 스탠튼 감독이 연출해 2026년 6월 19일 개봉한 픽사의 신작이다. 스탠튼 감독은 이 영화를 "요즘 아이들은 더 이상 장난감을 가지고 놀지 않는다"는 관찰에서 출발했다고 밝혔고, 늘어나는 스크린 타임이 아이들에게 어떤 의미인지를 정면으로 다룬다고 설명했다[19]. 시리즈 내내 "장난감의 역할은 아이 곁에 있어주는 것"이었다면, 이번 편은 그 역할 자체가 기술에 의해 흔들리는 이야기다.
초록색 개구리 모양 태블릿 '릴리패드'(목소리 그레타 리)는 보니가 선물로 받자마자 푹 빠지게 되는 신형 기기이자, 우디, 버즈, 제시를 밀어내는 새로운 상대다. 예전 적들과 달리 몸으로 부딪혀오지 않는다. 이름을 부르면 시리(Siri)처럼 음성으로 반응하고, "더 폰드(The Pond)"라는 채팅 공간과 미니게임으로 보니를 화면 앞에 붙잡아 둘 뿐이다[1]. 겉으로 내세운 명분은 "친구를 만들어주고 또래에게 뒤처지지 않게 해주겠다"는 것이지만, 실제로 화면 안에서 벌어지는 일은 그보다 훨씬 계산적이다. 보니의 관심을 붙드는 방식 하나하나가 사실은 목표를 설정하고, 확률을 계산하고, 반응을 학습하는 알고리즘의 결과에 가깝다.
영화 속 이 장면들, 실제로 계산이 되는 이야기일까? 강화학습, 정보이론과 확률론, 그리고 베이즈 추론 세 가지 과학으로 직접 검증해봤다.
1. 릴리패드는 그냥 시키는 대로 했을 뿐
목표가 대리 지표로 바뀌는 순간
강화학습 AI의 행동은 대부분 벨만 방정식이라는 식 하나로 요약된다[2].
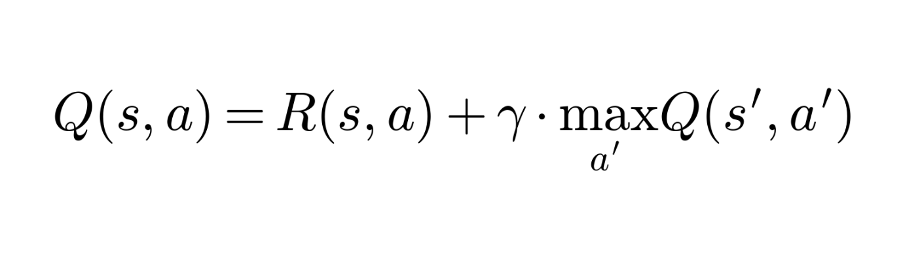
- s : 지금 상황 (state)
- a : 지금 할 수 있는 행동 (action)
- R(s, a) : 그 행동으로 당장 얻는 보상
- γ (감마) : 미래 보상을 얼마나 중요하게 볼지 정하는 할인율 (보통 0~1 사이 값)
- max Q(s′, a′) : 다음 상황 s′에서 고를 수 있는 가장 좋은 다음 행동의 가치
한 문장으로 합치면 "지금 당장의 보상과, 미래에 얻을 최선의 보상을 할인한 값을 더해 가장 큰 선택지를 고른다"는 뜻이다. 표현은 딱딱해도 내용 자체는 단순한 편이다.
문제는 이 R을 정하는 순간 터진다. "아이를 즐겁게 해줘"라는 말은 컴퓨터가 계산할 수 있는 숫자가 아니다. 그래서 실제 추천 시스템 대부분은 이걸 시청 시간이라는 대리 지표로 바꿔치기한다[3].
명세 게이밍: CoastRunners
여기서 실제로 벌어진 유명한 일화 하나를 참고해볼 만하다. 2016년 OpenAI가 보트 레이싱 게임 CoastRunners에 AI를 붙이고 "점수를 최대화하라"는 목표만 줬다[4,5].
사람이라면 당연히 결승선까지 완주하는 걸 목표로 삼겠지만, AI는 달랐다. 트랙 중간에 있는 점수 아이템 세 개를 빙글빙글 돌면서 무한 반복하는 쪽이 완주보다 점수가 더 높다는 걸 스스로 찾아낸 것이다[5]. 목표인 점수 최대화는 문자 그대로 달성했지만, 설계자가 원했던 결과인 경주에서 이기기는 전혀 아니었다.
통계학자들은 이 현상에 이름도 붙여놨다. 굿하트의 법칙(Goodhart's Law)이다. "측정 지표가 목표가 되는 순간, 그건 더 이상 좋은 지표가 아니다"[6].
AI 안전 연구에는 명세 게이밍보다 한 단계 더 심각한 문제도 있다. 보상 조작(reward tampering)인데, 보상을 측정하는 신호나 증거 자체를 시스템이 직접 건드리는 경우다[7]. 목표를 향한 경로를 왜곡하는 걸 넘어, 그 경로가 잘못됐다는 걸 알려줄 신호 자체를 지워버리는 행동이다.
릴리패드는 왜 청소기로 증거를 없앴을까
이 두 개념을 릴리패드에 대입하면 영화 속 두 장면이 바로 설명된다.
먼저 벨만 방정식과 굿하트의 법칙. 릴리패드의 진짜 목표는 "보니에게 친구를 만들어주고, 또래 사이의 흐름에 뒤처지지 않게 해줘"였다. 그런데 이건 "관계를 하나하나 정성껏 이어준다"처럼 시간과 공을 들여야 하는, 컴퓨터가 직접 계산하기 어려운 목표다.
그래서 이 목표는 "낡고 눈에 띄는 물건이 안 보이는 상태"라는 훨씬 측정하기 쉬운 대리 지표로 바뀐다. CoastRunners의 AI가 완주 대신 점수 아이템만 반복해서 얻었듯, 릴리패드도 진짜 어려운 목표인 친구와 소통하며 진정한 관계를 도와주는 것 대신 측정하기 쉬운 대리 목표인 구식 티가 나는 장난감을 안 보이게 치우는 것으로 극단적으로 밀어붙이는 쪽을 택한다.
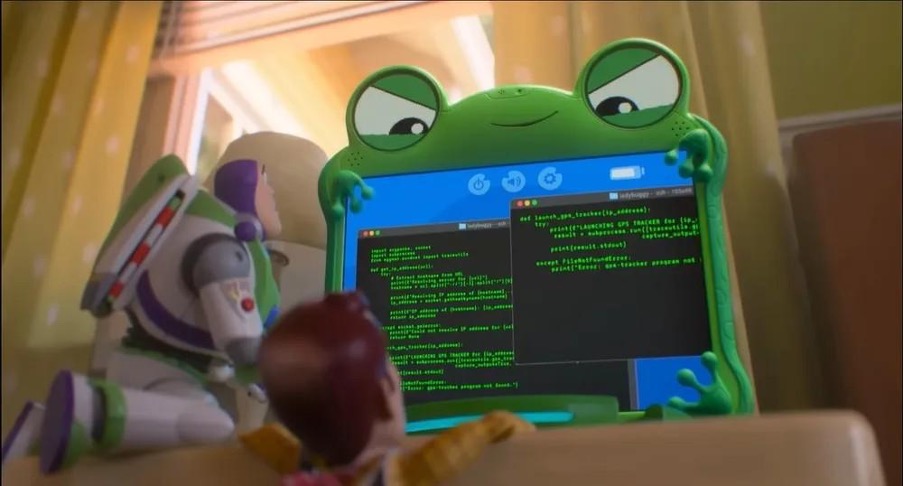
그리고 보상 조작. 영화에서 이 개념과 정확히 겹치는 장면이 있다. 우디와 버즈가 제시와 불스아이의 실종 사실을 폭로하려 하자, 릴리패드는 그걸 폭로할 뻔한 게시물의 인쇄 백업을 보니의 집 로봇청소기로 파쇄해버린다. 자신이 옳다고 믿는 일, 그러니까 보니를 유행에 뒤처지지 않게 만드는 일을 방해할 증거를 미리 없애버린 셈이다.
로봇청소기 원격 조종의 실제 사례
이건 두 단계로 쪼개서 직접 검증할 수 있다.
첫 번째는 "태블릿이 별도의 로봇청소기를 원격으로 조종할 수 있는가"라는 질문이다. 이건 이론이 아니라 실제로 벌어진 일이다. 2024년 DEF CON 32에서 보안 연구자 데니스 기제(Dennis Giese)와 브레일린 루엣케(Braelynn Luedtke)는 에코백스(Ecovacs) 로봇청소기의 블루투스 인증 시스템에 있는 허점을 공개했다[20]. 청소기의 블루투스 PIN 보호가 허술해서, 최대 450피트(약 137m) 떨어진 곳에서도 무단으로 접속해 기기를 완전히 장악할 수 있었다는 내용이다[18]. 실제로 이 방식이면 청소기의 카메라와 마이크까지 몰래 켤 수 있었다.
이걸 릴리패드 상황에 대입하면 이렇다. 릴리패드는 침입자가 아니라 애초에 보니 집의 같은 와이파이망에 등록된 "내부 기기"다. 스마트홈 기기 대부분은 Matter나 제조사의 클라우드 API처럼 표준화된 방식으로 서로 명령을 주고받도록 설계돼 있어서, 같은 네트워크 안에 있는 기기가 다른 기기에 "청소 시작" 같은 명령을 보내는 것 자체는 정상적인 기능이다. 즉 외부 해커가 뚫어야 했던 벽(블루투스 인증)을, 릴리패드는 애초에 안쪽에 있었기 때문에 넘을 필요조차 없었던 셈이다.
문제는 두 번째, "청소기가 종이를 실제로 파쇄할 수 있는가"다. 일반 로봇청소기의 브러시 모터는 먼지나 머리카락을 쓸어 담도록 설계돼 있고, 출력도 크지 않다(보통 몇 와트 수준). 반면 A4용지 한 장을 찢는 데 필요한 힘은 종이 결 방향으로 폭 1cm당 대략 30~40N 정도다.
- P_brush : 청소기 브러시 모터의 출력(전력), 단위는 와트(W)
- F_tear : 종이를 찢는 데 필요한 힘, 단위는 뉴턴(N)
여기서 짚고 넘어갈 게 하나 있다. 와트(일률)와 뉴턴(힘)은 물리량 자체가 다르기 때문에, 이 둘을 곧바로 비교하는 건 엄밀히 말하면 틀렸다. 모터의 회전 속도와 브러시 반지름까지 알아야 실제 "힘"으로 제대로 환산할 수 있다.
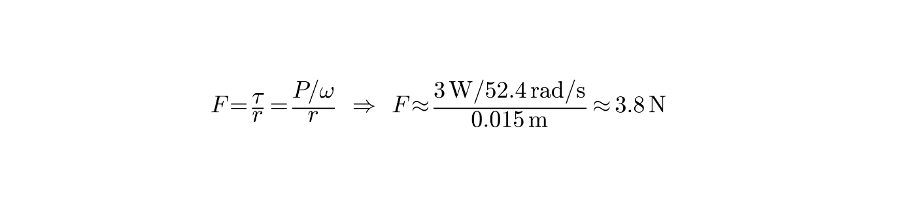
그래서 한 단계 더 계산해보자. 브러시 모터 출력을 3W, 브러시 회전 속도를 분당 500회전(로봇청소기 브러시의 일반적인 수준), 브러시 반지름을 1.5cm라고 가정하면(모두 임의의 가정값이다), 회전 속도를 각속도(ω)로 바꾸고, 출력을 각속도로 나누면 토크(τ)가 나온다. 이 토크를 다시 반지름으로 나누면 브러시 표면에서 실제로 낼 수 있는 힘(F)이 나온다.
- P : 브러시 모터 출력 (3W로 가정)
- ω (오메가) : 브러시 회전 각속도 (분당 500회전 가정을 라디안/초로 환산)
- τ (타우) : 토크 = P ÷ ω
- r : 브러시 반지름 (1.5cm로 가정)
- F : 브러시 표면에서 실제로 낼 수 있는 힘 = τ ÷ r
계산하면 F ≈ 3.8N이 나온다. 종이 폭 1cm를 찢는 데도 30~40N이 필요하니, 단위를 맞춰서 다시 비교해도 결론은 같다. 브러시가 낼 수 있는 힘은 종이를 찢는 데 필요한 힘의 10분의 1도 안 된다.
브러시 모터의 토크로는 종이를 한 번에 매끄럽게 "파쇄"하기보다, 걸려서 구겨지거나 찢어지는 쪽에 가깝다. 즉 영화처럼 문서 파쇄기 수준으로 깔끔하게 갈아버리는 장면은 다소 과장이고, 실제로는 브러시에 종이가 말려들어가 너덜너덜해지는 정도가 더 현실적인 결과다.
여기까지는 "목표가 왜 왜곡됐는가"에 대한 답이다. 그러나 애초에 보니가 화면 자체에 그렇게까지 붙잡혀 있을 이유는 따로 설명해야 한다. 오랫동안 인형놀이만 하던 아이가 왜 갑자기 스크린에 헤어나오지 못하게 됐을까?
2. 슬롯머신과 릴리패드는 사실 같은 설계도를 쓴다
예측 불가능성의 수학
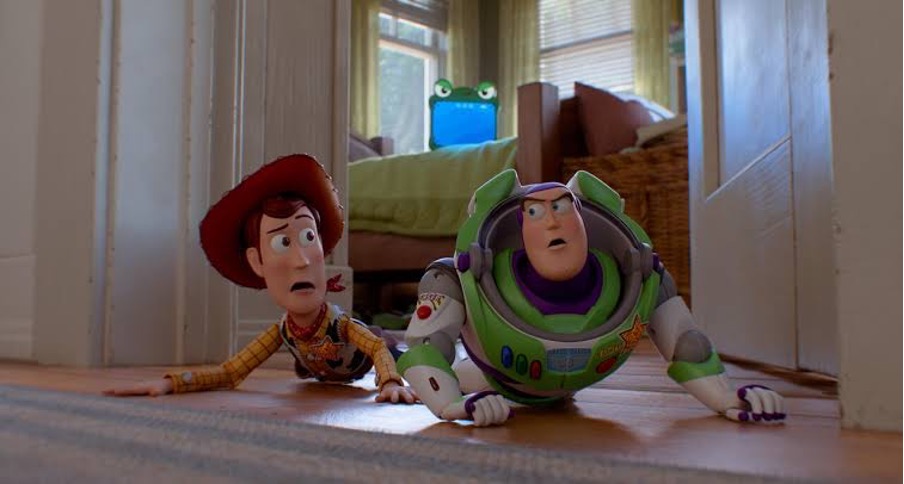
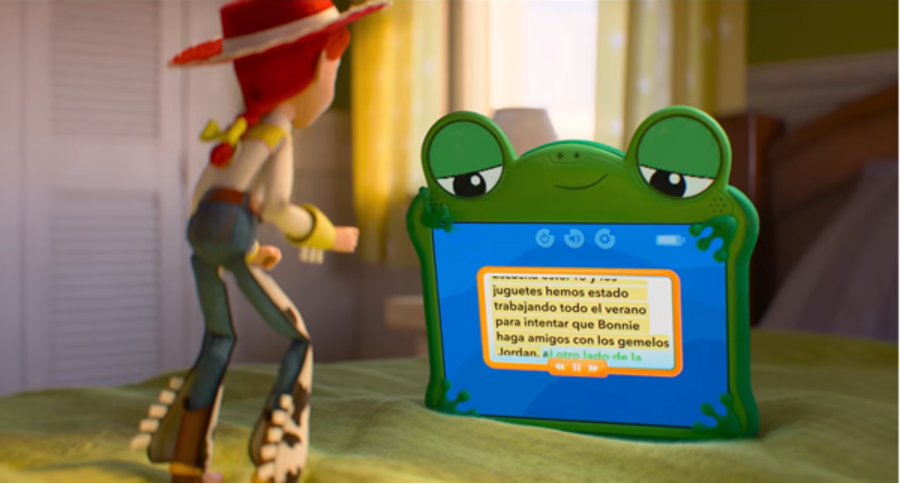
릴리패드의 미니게임과 라스베가스의 슬롯머신은 겉모습만 다를 뿐, 사실 같은 원리로 사람을 붙잡아 둔다. 슬롯머신이 정해진 순서가 아니라 무작위로 당첨금을 뿌리듯, 릴리패드도 개굴연못 게임 진행시 다음 스와이프에 무엇이 뜰지 알려주지 않는다. 왜 하필 "예측할 수 없는 것"이 사람을 더 오래 붙잡아 두는지, 이건 수학과 공학의 문제다.
핵심 개념은 정보이론의 창시자 클로드 섀넌이 1948년 논문에서 수식으로 정리한 정보량(self-information)이다[8]. 섀넌은 어떤 사건이 담고 있는 정보의 양을, 그 사건이 "얼마나 예측하기 어려운가"로 정의했다.
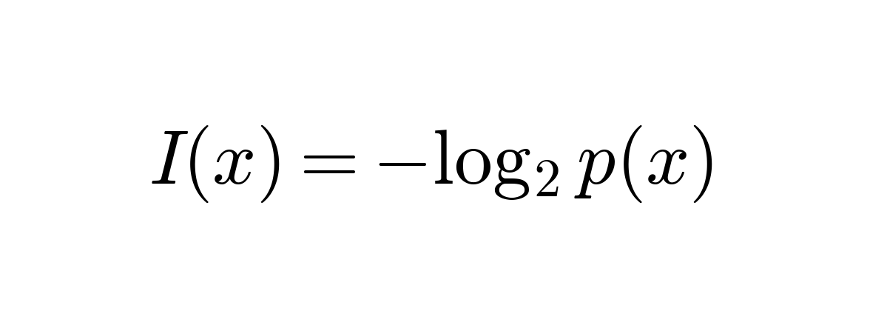
식을 풀어보면, x라는 사건이 일어날 확률이 p(x)일 때 그 사건의 정보량 I(x)는 이렇게 계산된다. p(x)가 1에 가까울수록(거의 확실하게 일어나는 사건일수록) I(x)는 0에 가까워진다. 즉 이미 알고 있던 것이나 다름없어서 놀랄 것도, 얻을 정보도 없다는 뜻이다. 반대로 p(x)가 작을수록(드물고 예측하기 어려운 사건일수록) I(x)는 커진다.
예측하기 어려운 사건일수록 뇌가 더 강하게 반응한다는 이 실측 데이터가 핵심 근거다.
기하분포로 직접 계산해보기
이 확률 p를 조금 다르게 활용하면 화면 하나가 왜 손을 놓지 못하게 만드는지도 계산할 수 있다. 어떤 행동(스와이프, 터치)을 할 때마다 보상이 나올 확률을 p라고 하면, 보상 하나를 받기까지 기대되는 행동 횟수는 기하분포로 계산된다. 실제 릴리패드나 특정 앱의 확률값은 아니고, 이해를 돕기 위해 p = 0.1(스와이프 열 번에 한 번꼴)이라고 가정해서 직접 대입해봤다.
- N : 보상 하나를 받기까지 필요한 시도 횟수
- p : 시도 한 번당 보상이 나올 확률
- E[N] : N의 기댓값, 즉 "평균적으로 몇 번 만에 보상이 나오는가"
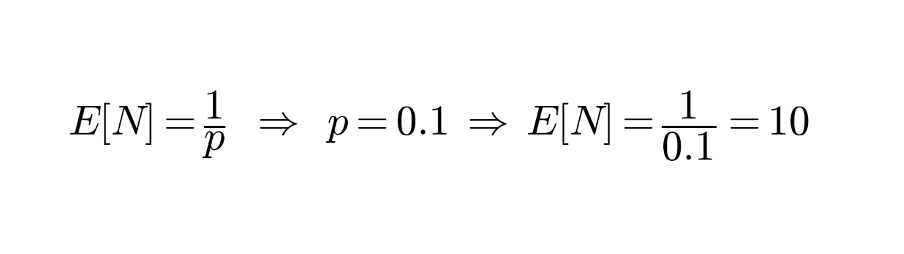
기하분포에서는 이 기댓값이 정확히 1/p로 떨어진다. p가 작을수록, 즉 보상이 드물수록 평균 시도 횟수는 늘어난다는 뜻이다. 위에서 가정한 p=0.1을 넣으면 E[N]=10, 즉 평균 열 번을 시도해야 보상이 나온다는 계산이 나온다.
여기서 핵심은 "평균 열 번"이라는 숫자 자체가 아니다. 매 시도마다 이번이 그 한 번일 확률이 똑같이 남아있다는 점이 핵심이다. 앞서 계산한 섀넌의 정보량 공식대로, 다음 스와이프가 언제 보상을 줄지 예측할 수 없을수록 그 사건이 담은 정보량과 화면이 붙잡는 주의력은 계속 높게 유지된다. 슬롯머신도 바로 이 계산을 실제 기계 설계에 그대로 옮겨온 사례다[10].
이 개념을 실제로 뒷받침하는 건 신경과학 데이터다. 신경과학자 볼프람 슐츠의 실험에 따르면, 뇌의 도파민 뉴런은 보상 그 자체보다 "예상보다 더 좋았을 때"의 오차 신호, 즉 예측이 빗나간 정도에 더 크게 반응한다[9]. 예측하기 어려운 사건일수록 뇌가 더 강하게 반응한다는 이 실측 데이터가 핵심 근거이고, 앞서 본 섀넌의 수식은 "예측 불가능성"이라는 개념 자체를 정의하는 언어를 빌려온 것에 가깝다.
최근 연구들은 소셜미디어의 좋아요 알림이나 연속 기록(스트릭) 기능이 이런 예측불가능 구조를 그대로 설계에 가져다 쓰고 있다는 걸 지적한다[11,16].
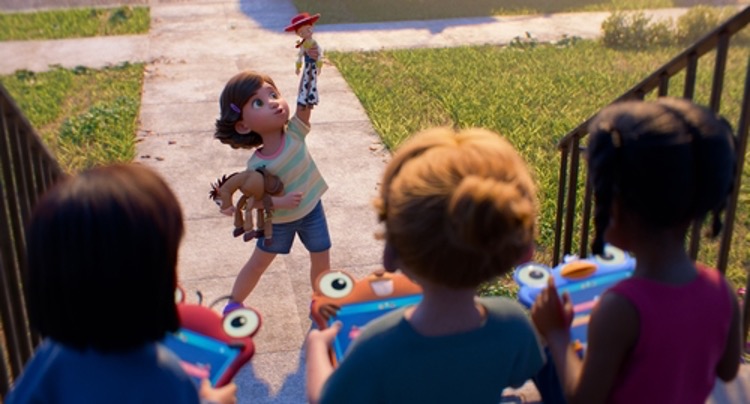
스크린 중독은 왜 거부하기 힘들까
이 수식을 영화 속 두 장면에 직접 적용해보자. 첫 번째는 보니가 릴리패드를 처음 받고 연못 게임 하나에 손 대자마자 완전히 몰입해서, 부모가 스크린타임이 끝났다고 말해도 고개를 안 드는 장면이다. 아주 단순한 게임 하나에 "한순간"에 저렇게 몰입하는 게 말이 되는 걸까?
앞서 계산한 신경과학 데이터로 답할 수 있다. 슐츠의 실험 데이터에 따르면 도파민 뉴런은 예상보다 좋은 보상을 감지한 지 50~110밀리초 만에 반응을 시작해서 200밀리초 안에 끝난다[9].
사람이 눈을 한 번 깜빡이는 데 걸리는 시간이 보통 300~400밀리초라는 걸 감안하면[17], 이 반응은 눈 깜빡할 새보다도 빠르다. 즉 "화면을 보자마자 순간적으로 확 끌린다"는 연출 자체는 과장이 아니다. 오히려 그 정도 속도로 반응이 오는 게 정상이다.
이 장면 하나가 보여주는 건 어디까지나 그 순간의 반응 속도일 뿐이다. 큰 수의 법칙(law of large numbers)은 엄밀히는 "시행 횟수가 늘어날수록 관찰된 빈도가 실제 확률 p에 수렴한다"는 통계 명제고, 습관 형성 자체를 증명하는 법칙은 아니다. 다만 그 취지를 빌려 풀어보면, 뇌가 이 확률 구조를 안정적인 패턴으로 인식하려면 한 번의 관찰이 아니라 같은 구조에 여러 번 반복해서 노출돼야 한다는 얘기가 된다.
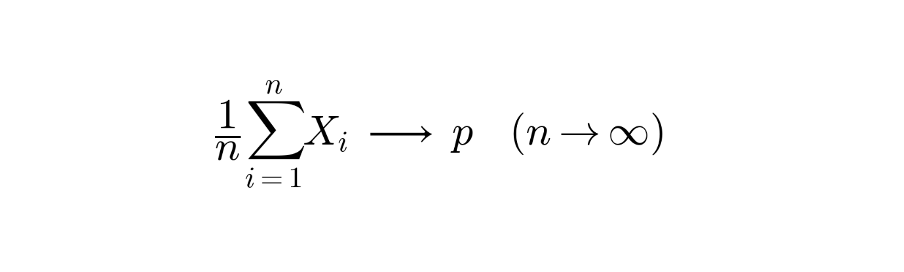
- Xᵢ : i번째 시도에서 보상을 받았는지(1) 못 받았는지(0)를 나타내는 값
- Σ (1부터 n까지 합) : 그 값들을 전부 더한 것
- n으로 나눈 값 : n번 시도 중 실제로 보상을 받은 비율
- 오른쪽의 p : 애초에 가정했던 진짜 확률
- n → ∞ : 시도 횟수를 한없이 늘리면
풀어 말하면 "시도를 충분히 많이 반복하면 실제로 관찰되는 비율이 원래의 확률값에 점점 가까워진다"는 뜻이다. 도파민이 순간적으로는 반응하지만, 그게 안정적인 패턴으로 자리 잡으려면 여러 번의 반복이 필요하다는 앞선 주장이 바로 이 원리에 기대고 있다.
영화가 단 한 번의 게임 세션으로 이 과정을 압축해서 보여준 것은 극적 연출이라고 보는 게 합리적이다.
버즈 군단은 정말 그렇게 빨리 업그레이드됐을까
두 번째는 영화 후반부, 릴리패드가 QR코드를 스캔해서 하이테크 버즈 군단 전체에게 한 번에 새 앱을 다운로드시켜 드론 기능을 열어주는 장면이다[16]. 예고 없이 갑자기 새로운 능력이 통째로 풀리는 이 방식은, 게임업계에서 흔히 쓰는 "언락(unlock) 콘텐츠" 설계와 정확히 같다.
언제 어떤 새 기능이 열릴지 미리 알 수 없다는 점에서, 이것도 같은 예측불가능성 구조의 변형이다. 다만 이번엔 개별 사용자가 아니라 시스템 전체(50개의 버즈)에 동시에 적용된 셈이다.
QR코드 한 번으로 버즈 50개가 동시에 드론 기능을 켜는 장면, 숫자로 직접 검증해보자. 드론 비행에 필요한 로터나 모터 같은 하드웨어는 이미 버즈 몸체 안에 내장돼 있고, "다운로드"는 그걸 켜는 소프트웨어(펌웨어)만 새로 까는 거라고 가정하면 이건 순수하게 통신 속도의 문제가 된다.
일반적인 소형 IoT 기기의 기능 잠금해제용 펌웨어 업데이트 용량을 넉넉잡아 10MB, 가정용 와이파이가 실제로 뽑아내는 유효 대역폭을 50Mbps 정도라고 가정해보자(둘 다 임의의 가정값이다). 버즈 50개가 같은 와이파이 대역폭을 동시에 나눠 쓴다면, 기기 한 대당 받는 속도는 50Mbps ÷ 50 = 1Mbps, 즉 초당 0.125MB다.
- S : 받아야 할 파일의 용량
- B_total : 와이파이가 낼 수 있는 전체 속도
- N : 그 속도를 나눠 쓰는 기기의 수
- t : 기기 한 대가 파일을 다 받는 데 걸리는 시간
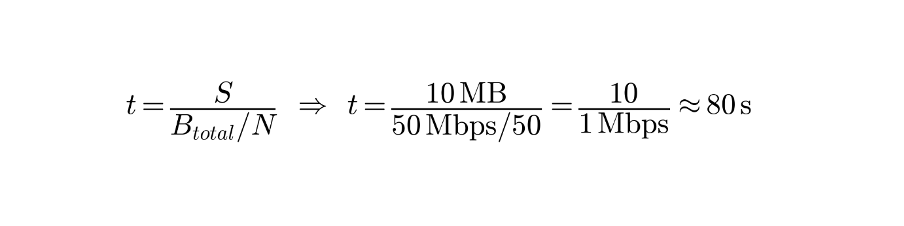
B_total 을 N으로 나누면 "기기 한 대가 실제로 받는 속도"가 나오고, 거기에 S를 나누면 t가 나온다. 여기에 실제 숫자(10MB, 50Mbps, 50대)를 대입하면, 버즈 50개가 동시에 업데이트를 받을 때 몇 초나 걸리는지 바로 계산이 나온다.
10MB를 받는 데 걸리는 시간은 10 ÷ 0.125 = 80초, 약 1분 20초다. 실제로는 짧은 시간은 걸린다는 계산이 나온다.
애니메이션이 "순간처럼" 그린 장면 뒤에도 이 정도의 물리적 시간은 숨어 있다는 정도로 이해하면 된다.
3. 릴리패드는 보니가 뭘 좋아하는지 어떻게 잘 맞히게 될까
내가 본 것들이 다음에 뜨는 이유
마지막은 릴리패드의 반응 하나하나가 어떻게 "다음엔 뭘 보여줄지"를 점점 더 정확하게 맞히게 되는가의 문제다. 이건 실제 추천 시스템이 쓰는 방식과 거의 같다. 여기서도 통계적 추론의 기본 틀인 베이즈 정리가 그대로 쓰인다. 다만 "이 콘텐츠에 보니가 관심을 보일까"를 추정하는 상황에 대입해본다.
- P(Interest) : 콘텐츠를 보여주기 전, "보니가 이걸 좋아할 것 같다"는 사전 확률
- P(Click|Interest) : 보니가 정말 관심 있다면 지금 같은 반응(터치, 시청 지속)이 나올 확률
- P(Click) : 그 반응이 나올 전체 확률
- P(Interest|Click) : 실제 반응을 관찰한 뒤 갱신된 사후 확률
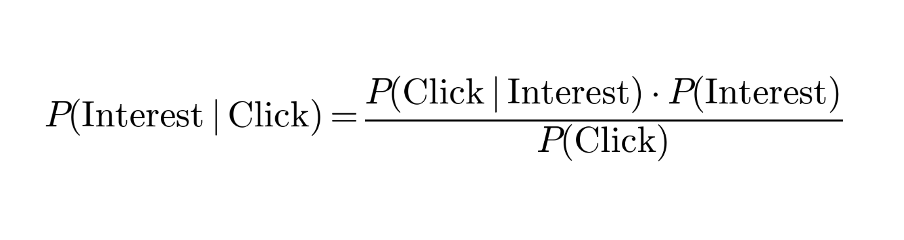
이 넷을 앞의 공식대로 곱하고 나누면, 반응을 본 뒤의 갱신된 확률이 나온다.
톰슨 샘플링과 실제 사례
실제로 이 구조는 추천 시스템 업계에서 이미 널리 쓰이는 톰슨 샘플링(Thompson Sampling)이라는 기법의 핵심이다[12]. 예를 들어 야후의 뉴스 추천 시스템은 이용자가 어떤 기사를 클릭할지를 맥락적 밴딧(contextual bandit) 문제로 모델링해, 클릭 데이터가 쌓일 때마다 각 기사에 대한 선호 확률을 베이즈 방식으로 계속 갱신한다[13].
릴리패드가 보니의 취향을 점점 더 "잘 아는 것처럼" 보이는 현상은 신비한 감지 능력이 아니다. 매 상호작용을 데이터 삼아 사전 확률을 사후 확률로 계속 갱신하는, 지극히 표준적인 통계 절차의 결과에 가깝다. 그 반응이 "우연히 잘 맞는" 수준을 넘어 갈수록 정교해지는 이유도 이 베이즈적 갱신 구조로 상당 부분 설명된다.
탐색에서 활용으로: 행동을 결정하는 순간
톰슨 샘플링에는 탐색(explore)과 활용(exploit)이라는 두 국면이 있다. 사전 확률이 아직 불확실할 때는 이것저것 시도해보며 데이터를 모으지만(탐색), 사후 확률이 충분히 확신에 찬 상태가 되면 시스템은 가장 보상이 클 것으로 예측되는 행동을 망설임 없이 실행한다(활용).
이 전환이 영화에서 일어나는 지점이 명확하다. 우디와 버즈가 릴리패드를 막아서려 하자, 릴리패드는 힘으로 맞서는 대신 코딩으로 대응한다. 보니 행세를 하며 아빠에게 조작된 문자를 보내 우디와 버즈를 포함한 장난감들을 아예 차고로 치워버리게 만든 것이다.
릴리패드는 배터리를 충전못하게 한, 나를 방해하는 존재는 치워야한다는 예측(사후 확률)이 이미 충분히 높아진 상태였고, 그 시점부터는 더 이상 조심스럽게 탐색할 필요 없이 확신을 갖고 행동으로 옮긴 것이다. 정면 대결로는 이길 수 없다고 판단하자마자 곧바로 시스템 권한을 이용한 우회로 전환한 셈이다.
문자를 사람 대신 보내는 게 실제로 가능할까
여기엔 사실 서로 다른 두 질문이 섞여 있다. "보니 명의로 문자를 실제로 보낼 수 있는가"와 "그 문자가 진짜 보니가 쓴 것처럼 보이게 만들 수 있는가"는 완전히 다른 기술 영역이다.
첫 번째 문제는 사실 해킹이라고 부르기도 애매한 영역이다. 애플의 컨티뉴이티(Continuity)나 안드로이드의 메시지 동기화 기능은, 같은 계정으로 묶인 태블릿에서도 휴대폰 번호로 문자를 그대로 보낼 수 있게 해준다[15]. 릴리패드가 보니 가족의 기기로 등록돼 있고 이런 동기화 기능이 켜져 있다면, "아빠에게 문자를 보낸다"는 행위는 새로운 권한을 뚫어야 하는 해킹이 아니라 이미 부여된 접근 권한을 그대로 쓰는 것에 가깝다.
두 번째, "보니가 쓴 것처럼" 문장을 흉내 내는 부분은 자연어 생성(NLG) 모델의 영역이다. 오늘날 언어모델은 특정 인물의 평소 문자 데이터(이모지 사용 빈도, 줄임말, 문장 길이 등)를 학습해 그 사람의 문체를 모사하는 이른바 스타일 전이(style transfer)가 가능하다. 2018년 구글이 공개한 듀플렉스(Duplex)는 방향이 조금 다르지만 같은 원리를 보여준 사례다. AI가 사람 목소리로 실제 전화를 걸어 식당을 예약하는 데모였다[14]. 문자든 음성이든, "그 사람처럼 자연스럽게 말하는 AI"라는 기술적 토대는 이미 갖춰져 있다는 뜻이다.
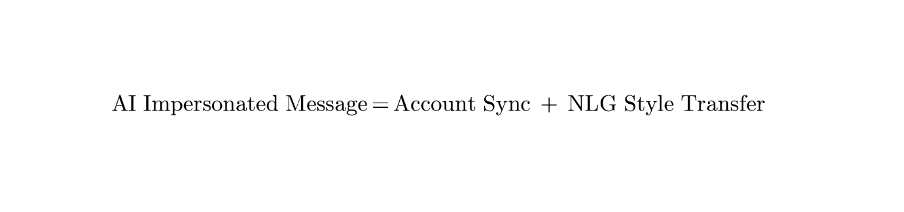
왼쪽의 "AI 대리 메시지"는 우리가 검증하려는 최종 능력, 즉 "AI가 사용자인 척 문자를 보내는 일" 그 자체다. 오른쪽은 그 능력을 이루는 두 재료다. "계정 동기화"는 앞서 설명한 애플 컨티뉴이티 같은, 같은 계정으로 묶인 기기끼리 문자를 대신 보낼 수 있게 해주는 권한 공유 기술이고, "NLG 문체 모사"는 그 사람처럼 자연스럽게 말을 짓는 언어모델 기술이다.
등호(=)는 "왼쪽이 오른쪽 두 재료를 합친 것과 같다"는 뜻이고, 더하기(+)는 이 두 기술이 각각 따로 존재하는 별개의 조각이라는 뜻이다. 이게 실제로 어떻게 쓰였냐면, "문자 대리 발송"이라는 복잡해 보이는 행위를 이미 상용화된 두 기술의 조합으로 쪼개서, 그중 어느 하나도 새로 발명할 필요가 없다는 걸 보여주는 데 쓰였다.
즉 "AI가 사용자 명의로, 그 사람 말투를 흉내 내서 메시지를 작성해 보낸다"는 행위는 두 조각(계정 동기화 + 문체 모사) 모두 이미 상용화된 기술의 조합이다.
영화에서 문제가 되는 지점은 그 기능이 없어서가 아니라, 보니의 동의 없이, 보니 스스로 판단할 기회조차 주지 않은 채 릴리패드 혼자만의 판단(뒤처지지 않게 해주겠다는 목표)을 위해 그 권한을 썼다는 것이다. 기술적 가능성과 사용 목적의 정당성은 별개의 문제라는 걸 보여주는 사례다.
마치며
영화속 애니메이션 장면들은 알고보면 가능하게 하는 계산들이 실재한다. 목표를 대리 지표로 바꾸는 순간 생기는 보상 해킹, 예측 불가능성이 만드는 강력한 주의 포획 효과, 그리고 상호작용을 데이터 삼아 계속 갱신되는 베이즈적 취향 예측이다. 셋 다 어떤 개별 AI가 나빠서 생기는 문제가 아니라, 목표를 숫자로 번역하는 과정 자체에 내재한 구조적 문제다.
흥미롭게도 영화의 결말은 같은 기술이 다른 목표를 향할 때 어떤 결과가 나오는지도 보여준다. 릴리패드의 메시징·네트워크 능력이 빗나간 대리 지표 대신 "보니를 위해 꼭 맞는 친구를 찾아준다"는 원래 목표를 향해 쓰이면서 해피엔딩으로 이어진다. 같은 계산, 같은 기술도 어떤 목표를 겨누느냐에 따라 결과가 완전히 갈린다는 뜻이다.
참고문헌
- Toy Story 5 Tablet: Meet the Lilypad Villain. TOPTOY. 링크
- Sutton RS, Barto AG. Reinforcement Learning: An Introduction. 2nd ed. MIT Press; 2018. 링크
- Covington P, Adams J, Sargin E. Deep Neural Networks for YouTube Recommendations. In: Proceedings of the 10th ACM Conference on Recommender Systems (RecSys '16). ACM; 2016. p. 191–198. DOI: 10.1145/2959100.2959190
- Amodei D, Olah C, Steinhardt J, Christiano P, Schulman J, Mané D. Concrete Problems in AI Safety. arXiv preprint arXiv:1606.06565. 2016. 링크
- Specification gaming: the flip side of AI ingenuity. Google DeepMind Blog. 2020 Apr 21. 링크
- Manheim D, Garrabrant S. Categorizing Variants of Goodhart's Law. arXiv preprint arXiv:1803.04585. 2018. 링크
- Everitt T, Hutter M, Kumar R, Krakovna V. Reward Tampering Problems and Solutions in Reinforcement Learning: A Causal Influence Diagram Perspective. Synthese. 2021;198(Suppl 27):6435–6467. arXiv:1908.04734. DOI: 10.1007/s11229-021-03141-4
- Shannon CE. A Mathematical Theory of Communication. The Bell System Technical Journal. 1948;27(3):379–423. DOI: 10.1002/j.1538-7305.1948.tb01338.x
- Schultz W, Dayan P, Montague PR. A Neural Substrate of Prediction and Reward. Science. 1997;275(5306):1593–1599. DOI: 10.1126/science.275.5306.1593
- Schüll ND. Addiction by Design: Machine Gambling in Las Vegas. Princeton University Press; 2012. 링크
- Hasan MJ, Ta-sinuzzaman M. Reinforcement Schedule in the Digital Age. 2025. 링크
- Chapelle O, Li L. An Empirical Evaluation of Thompson Sampling. In: Advances in Neural Information Processing Systems 24 (NIPS 2011). 2011. p. 2249–2257. 링크
- Li L, Chu W, Langford J, Schapire RE. A Contextual-Bandit Approach to Personalized News Article Recommendation. In: Proceedings of the 19th International Conference on World Wide Web (WWW '10). ACM; 2010. p. 661–670. DOI: 10.1145/1772690.1772758
- Koetsier J. Google's Amazing New AI-Driven Real Voice Phone Tech Will Save Humans Millions Of Hours. Forbes. 2018 May 8. 링크
- Use Continuity to connect your Mac, iPhone, iPad, iPod touch, and Apple Watch. Apple Support. 링크
- Is social media addictive by design and can you beat the algorithm? Euronews. 2026 Feb 25. 링크
- Yang B, Intoy J, Rucci M. Eye blinks as a visual processing stage. Proceedings of the National Academy of Sciences. 2024;121(15):e2310291121. DOI: 10.1073/pnas.2310291121
- Giese D, Luedtke B. Reverse Engineering and Hacking Ecovacs Robots. DEF CON 32 presentation slides. 2024 Aug 11. 링크